Excel 的基本函數非常適合簡單的計算,但在處理複雜的資料分析時,它們很快就會變得複雜。最終,您將獲得難以閱讀的巢狀公式、使電子表格變得雜亂無章的多個輔助列,以及在資料更改時公式可能會中斷的情況。這時,Excel 中的陣列公式就派上用場了。

陣列公式可讓您使用單一公式對整個資料範圍執行計算。 因此,您可以 執行閃電般快速的搜索、過濾和排序,使用一個強大的表達式,而不必為每一行或每一列編寫單獨的公式。 這對 Excel 來說並不新鮮,但是當這些功能可以讓他們的工作更簡單、更有效率時,有些人仍然堅持舊的做事方式。
快速連結
5. X查找
每次都優於 VLOOKUP。
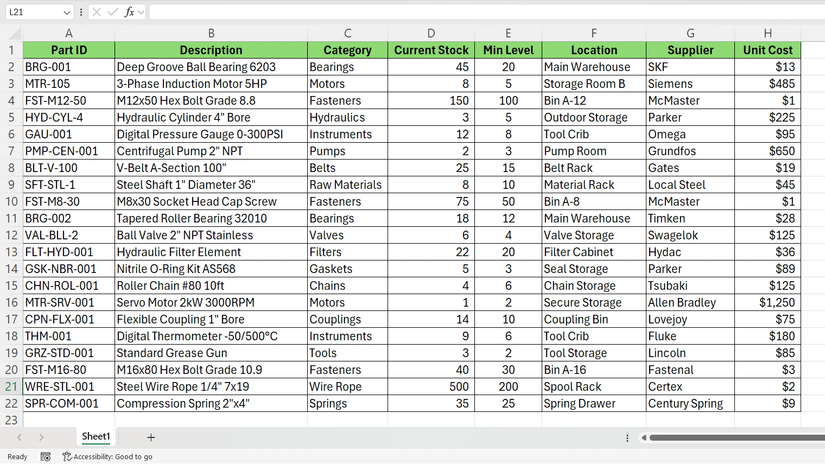
XLOOKUP 是一個從一開始就應該存在的查找函數。與強制計算列數並僅向右搜尋的 VLOOKUP 不同,XLOOKUP 可以向任意方向查找,並使用實際的欄位參考。它的語法如下:
=XLOOKUP(查找值,查找數組,返回數組,[如果找不到],[匹配模式],[搜尋模式])
每個參數的意義如下:
- 查找值: 您要尋找的具體值。這可以是零件編號、產品代碼或資料集中的任何識別碼。
- 查找數組: Excel 搜尋的範圍 Lookup_Array中 您的。這通常是包含您的搜尋條件的單列或單行。
- 返回數組: 包含要檢索的值的範圍。這可以是單列、多列,甚至是整個表格部分。
- if_not_found(可選): 未找到符合項目時顯示的自訂文字或值。它可以消除煩人的 #N/A 錯誤,並允許您顯示“未找到”或“檢查零件編號”。
- match_mode(可選): 控制匹配類型。 0 表示完全匹配(預設),-1 表示下一個完全匹配或更小的匹配,1 表示下一個完全匹配或更大匹配,2 表示通配符匹配。
- 搜尋模式(可選): 指定搜尋方向。使用 1 表示從頭到尾搜尋(預設),使用 -1 表示從頭到尾搜索,使用 2 表示對已排序資料進行二分搜尋。
我們以一個機械庫存電子表格為例。以下公式在一系列零件 ID 中搜尋零件號碼“BRG-002”,並傳回對應的資料。如果該零件不存在,則顯示“未找到零件”而不是錯誤。
=XLOOKUP("BRG-002", A:A, A:H, "找不到零件")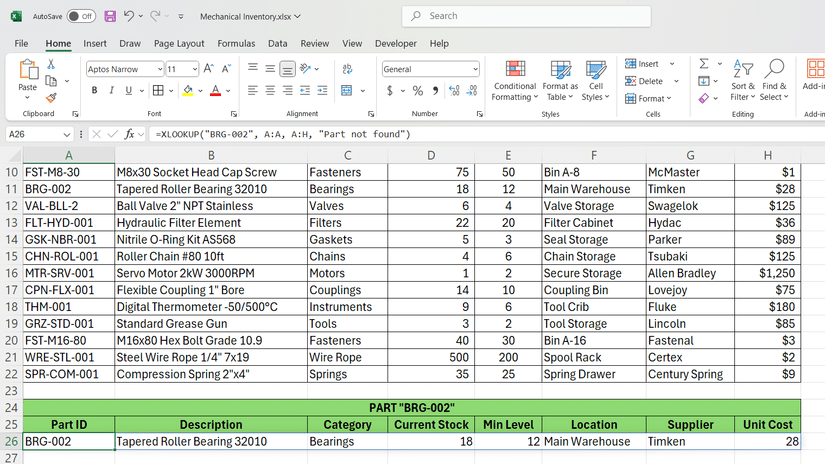
XLOOKUP 允許您從不同的列中提取數據,而無需像 VLOOKUP 那樣進行繁瑣的列計算,這使其成為最重要的 Excel 函數快速找出數據.
4. SUMPRODUCT
發電站條件計算
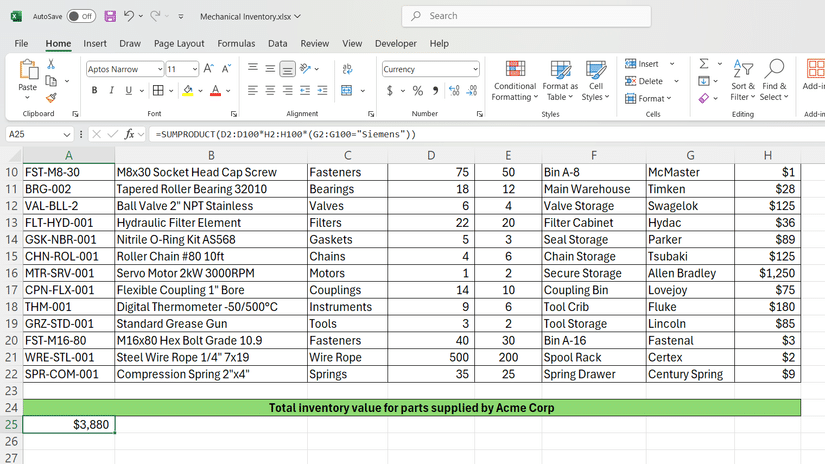
SUMPRODUCT 不僅可以對數字進行加法運算,還可以對矩陣進行乘法運算並對結果求和。這對於需要多個輔助列的複雜條件計算非常有用。
其公式如下:
=SUMPRODUCT(array1, [array2], [array3], ...)
這裡, 數組1 這是第一個要相乘的值範圍-通常是您的主要資料列,例如數量或成本。 數組2 它是乘法的可選第二個範圍,通常包含使用比較運算子的條件或條件邏輯。
當我們在陣列中使用邏輯運算子時,它們會變得更加有用。例如,當我們輸入諸如 (supplier="Siemens") 之類的條件時,Excel 會將 TRUE/FALSE 結果轉換為 1/0,以便進行計算。
例如,以下公式計算僅由西門子供應的零件的總庫存價值。此公式將數量乘以單位成本,但僅適用於供應商符合條件的行。
=SUMPRODUCT(D2:D100*H2:H100*(G2:G100="Siemens"))
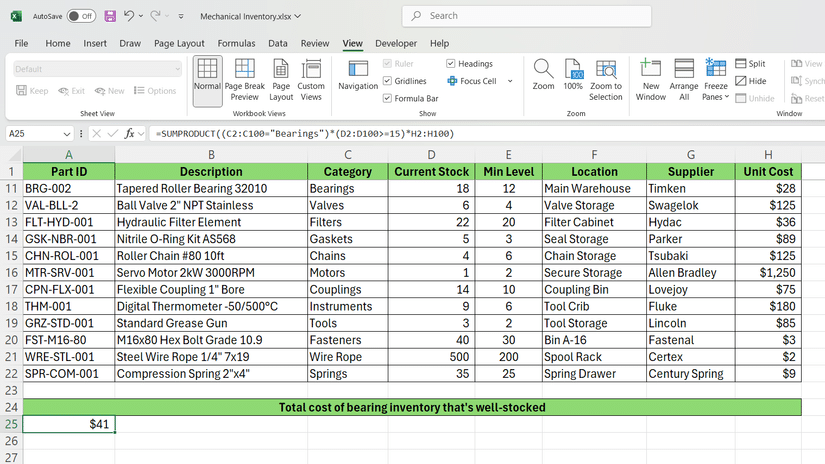
類似地,以下公式可以計算出庫存充足的軸承的總成本:
=SUMPRODUCT((C2:C100="Bearings")*(D2:D100>=15)*H2:H100)
兩個條件同時適用 - 類別必須是“軸承”,庫存水準必須為 15 個單位或更高,這有助於我們識別具有足夠庫存覆蓋率的軸承類別。
與具有多個條件的傳統 SUM 函數不同,SUMPRODUCT 不需要複雜的巢狀結構,因為它可以在單一可讀的公式中處理多個條件。 Excel 中的 SUM 函數, 與 SUMIF 和 SUMIFS 一樣,它們非常適合簡單的條件求和,但是當您需要在求和之前將值相乘或處理更複雜的邏輯運算時,SUMPRODUCT 函數表現出色。
3. 篩選
讓動態資料擷取變得簡單
FILTER 根據您指定的條件從資料集中提取行。與手動過濾不同,此函數會產生動態結果,並在來源資料變更時自動更新。 FILTER 語法如下:
=過濾器(數組,包括,[if_empty])
以下是每個輸入控制的內容:
- 數組(範圍): 您想要過濾的全部資料範圍。這包括您想要在結果中顯示的所有列,而不僅僅是條件列。
- 包括(包括): 指定傳回哪些行的邏輯條件 - 使用比較運算子為每一行建立 TRUE/FALSE 陣列。
- if_empty(可選): 當沒有符合條件的行時顯示自訂訊息。避免出現 #CALC! 錯誤,並顯示有意義的文本,例如「未找到匹配結果」。
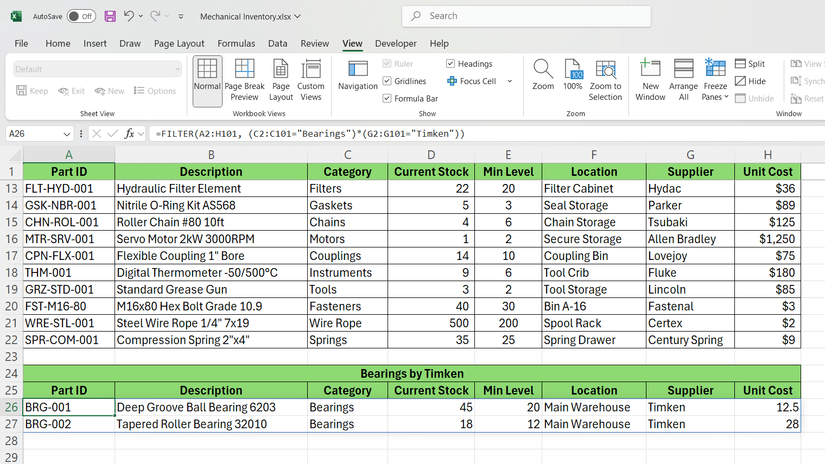
此函數的工作原理是針對範圍內的每一行評估您的條件。當條件回傳 TRUE 時,整行都會顯示在篩選結果中。以下是機械庫存電子表格的範例:
=FILTER(A2:H101, (C2:C101="Bearings")*(G2:G101="Timken"))
此公式提取資源為「Timken」且類別為「軸承」的所有行。星號 (*) 透過將邏輯數組相乘來建立 AND 條件。
當您向來源範圍新增資料時, 在 Excel 中使用 FILTER 函數 它比手動排序和臨時表更有意義,因為過濾結果會自動更新。這對於建立即時儀表板和報告非常有用。
2. 獨特
提取不重複的唯一值
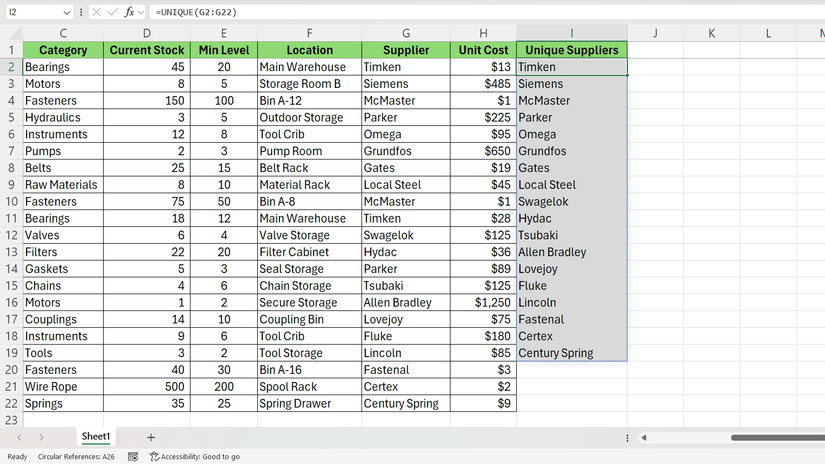
UNIQUE 從您的資料範圍中提取唯一值,並自動避免重複。如果您要建立下拉清單、分析資料類別以及建立總計報告,此功能非常重要。公式為:
=UNIQUE(array, [by_col], [exactly_once])
每個輸入的工作原理如下:
- 數組(範圍): 包含要從中刪除重複項的資料的範圍 - 可以是單列、多列或表格的整個部分。
- by_col(可選): FALSE 表示比較行以決定唯一性(預設),而 TRUE 表示比較列。不過,大多數情況下都使用預設的行比較。
- exactly_once(可選): FALSE 傳回所有唯一值,包括出現多次的值(預設),TRUE 僅傳回資料集中恰好出現一次的值。
UNIQUE 函數會計算陣列中的每一行或每個值,並只傳回每個唯一元素的第一次出現。其順序與原始資料序列一致。以下是範例:
=UNIQUE(G2:G22)
此公式從「供應商」列 G 中提取所有唯一供應商名稱,並建立一個乾淨的重複清單。我用它來建立供應商下拉清單或匯總報表。
您也可以在整個表格中使用它,如下所示:
=UNIQUE(A2:F100)
傳回所有欄位(A 至 F)中的唯一組合,顯示不同的庫存記錄。如果兩個零件在每列中的值相同,則結果只會顯示一個。
處理大型資料集時,UNIQUE 省去了手動刪除重複項的繁瑣過程。動態結果會隨著新資料的到來而更新,而且由於 UNIQUE 會建立溢出矩陣,因此這種方法可以自動縮放以容納所有唯一值,從而省去了調整表格大小的麻煩。我用它來維護乾淨的參考清單並建立可靠的資料驗證範圍。
1. SORT 和 SORTBY
在不損害原始數據的情況下組織您的數據
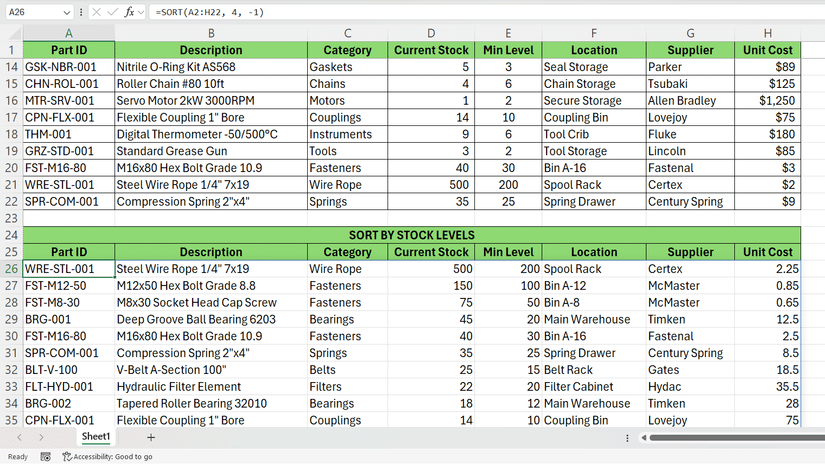
SORT 和 SORTBY 函數可在保持資料來源完整的情況下動態組織資料。 SORT 函數按列位置進行基本排序,而 SORTBY 函數則根據不同列中的值進行排序,從而為您提供更靈活的複雜排序功能。
SORT 使用以下結構:
=排序(數組,[sort_index],[sort_order],[by_col])
以下是每個參數控制的內容:
- 數組: 您要排序的資料範圍 - 包括應出現在排序結果中的所有欄位。
- 排序索引(可選): 數組中用於排序的列號。第一列使用 1,第二列使用 2,依此類推(預設為 1)。
- 排序順序(可選): 使用 1 表示升序(預設),使用 -1 表示降序。
- by_col(可選): FALSE 表示按行排序(預設),TRUE 表示按列排序-大多數情況下使用行排序。
SORTBY 函數採用以下形式:
=SORTBY(陣列, by_array1, [sort_order1], [by_array2], [sort_order2], ...)
其交易包括:
- 數組: 要排序的資料範圍 - 類似於 SORT 函數,它包含您想要在結果中顯示的所有欄位。
- 按數組1: 包含確定排序順序的值的範圍-可以是任何列,甚至在主數組的範圍之外。
- sort_order1(可選): 1 表示升序(預設),-1 表示降序。
- by_array2,sort_order2(可選): 多級排序的附加排序標準。
查看機械庫存電子表格中的範例,這些函數可處理現實世界的排序場景:
=SORT(A2:H22, 4, -1)
這會按庫存水準降序對整個庫存進行排序,庫存水準最高的商品會顯示在最前面。公式按第 4 列(庫存水準)排序,同時保留行之間的所有關係。
我正在使用 SORTBY 函數。 您可以使用它來代替 SORT,以便更好地控制排序條件和多個排序層級。例如,以下公式首先按類別的字母順序排序,然後按每個類別中的庫存水準從高到低排序。
=排序(A2:H22, C2:C22, 1, D2:D22, -1)
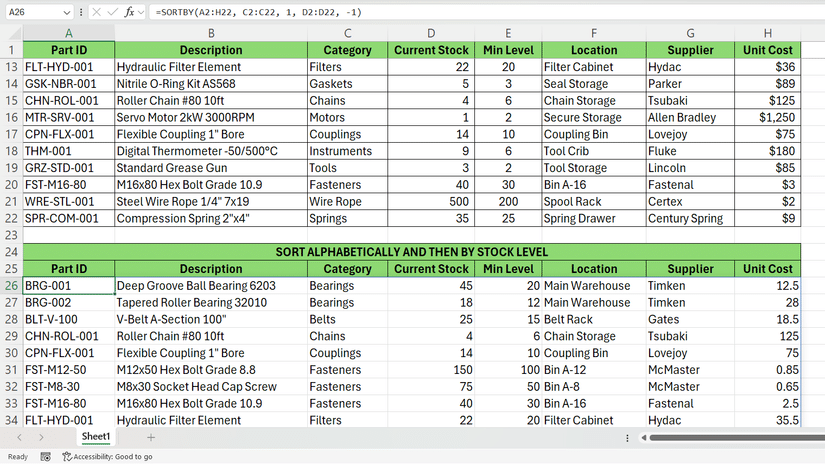
有序的電子表格,更聰明的結果
陣列公式消除了輔助列和巢狀函數帶來的雜亂,避免了電子表格維護的難題。您只需一個公式即可處理多項操作,讓工作簿更簡潔、更專業。
動態函數的一大顯著優勢是,當來源資料發生變化時,結果會自動更新。這消除了手動更新或公式字串損壞的麻煩,使您的電子表格在持續分析中更加可靠。
Excel 的陣列函式庫不斷擴展,超越了這些基本工具。當我需要合併來自多個來源的資料時,我會使用 VSTACK 和 HSTACK 函數來合併範圍。這些函數共同創建了強大的資料處理工作流程,這是傳統公式無法實現的。