像 grep 和 ack-grep 這樣的命令列工具非常適合在純文字檔案中搜尋與特定正規表示式相符的模式。但是,您是否嘗試過使用這些實用程式在 PDF 文件中搜尋模式?嗯,沒有!您將無法獲得任何結果,因為這些工具無法 搜尋 PDF 文件他們只讀取純文字檔案。

pdfgrep顧名思義,grep 是一個小型命令列工具,無需打開 PDF 文件即可搜尋文字。它的搜尋速度極快,幾乎比所有 PDF 閱讀器提供的搜尋速度都要快。 grep 和 pdfgrep 的主要區別在於,pdfgrep 以頁面為單位進行操作,而 grep 以行為單位進行操作。此外,如果一行中包含多個句子,grep 也會將同一行列印多次。讓我們來看看如何使用這個工具。
快速連結
作品
對於 Ubuntu 和其他基於 Ubuntu 的 Linux 發行版來說,這非常簡單:
sudo apt install pdfgrep
對於其他發行版,只需提供 pdfgrep。 作為套件管理器的入口,必須取得並安裝。您也可以造訪以下項目頁面: GitLab,以防您想試用代碼。
運行測試
現在工具已經安裝完畢,讓我們執行測試。 pdfgrep 指令的格式如下:
pdfgrep [選項...] 模式 [文件...]
- OPTION 是賦予指令的附加屬性列表,例如 -i 或 -ignore-case,它們會忽略指定正規模式的大小寫以及檔案中符合的大小寫。
- PATTERN 只是一個擴展的正規表示式。
- 如果檔案位於相同工作目錄中,則 FILE 只是檔案的名稱,否則是檔案的路徑。
我在 Python 3.6 官方文件上運行了該命令。下圖是結果。
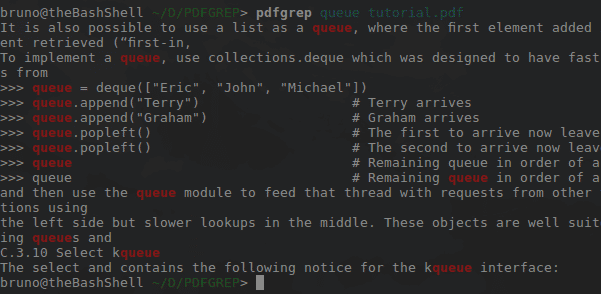
紅線表示所有出現“queue”一詞的位置。將 -i 作為選項傳遞給命令,即可找到包含「Queue」一詞的單字。記住,傳遞 -i 作為選項時,大小寫無關緊要。
附加功能
pdfgrep 有許多有趣的選項可供使用。不過,我們在這裡只介紹其中幾個。
完整的批准選項清單可以在男士頁面或 pdfgrep 線上指南別忘了,如果您處理的是鬆散文件,pdfgrep 可以一次搜尋多個文件。您可以透過變更 GREP_COLORS 環境變數來變更預設的高亮顏色。
結論
下次你想開啟 PDF 檔案搜尋內容時,可以考慮使用 pdfgrep。這個工具很方便,可以節省你的時間。