目前,人工智慧聊天機器人擁有自由且人為的許可,可以在未經許可的情況下抓取網站內容並使用可用資訊。您是否擔心這些工具會危及您的內容存取權限?
好消息是,您可以阻止 AI 工具訪問您的網站,但也有一些注意事項。在這裡,我們將向您展示如何使用網站的 robots.txt 檔案來阻止機器人,以及這樣做的優點和缺點。查看 如何創建完美的 Robots.txt 檔案以促進 SEO:它是什麼以及如何詳細使用它.
快速連結
人工智慧聊天機器人如何存取網路內容?
AI 聊天機器人使用多個海量資料集進行訓練,其中一些資料集是開源的,可以公開取得。例如,根據發表於 2019 年的一篇研究論文,GPT3 使用了五個資料集進行訓練。 OpenAI:
- 聯合爬行(60% 的訓練資料)。
- WebText2(佔訓練資料的 22%)。
- Books1(佔訓練資料的 8%)。
- Books2(佔訓練資料的 8%)。
- 維基百科(2% 的訓練資料)。
這包括 關節爬行 自 2008 年以來,已從網站收集了數 PB(數千 TB)的數據,類似於Google的搜尋演算法抓取網頁內容的方式。 WebText2 是由 OpenAI 創建的資料集,其中包含近 4500 萬個連結到 Reddit 貼文的網頁,這些貼文至少獲得了 3 個讚。
因此,就 ChatGPT 而言,AI 模型不會直接存取和抓取你的網頁——至少目前還不會。儘管 OpenAI 宣布將推出一款支援 ChatGPT 的網頁瀏覽器,引發了人們的擔憂,認為這種情況可能即將改變。
同時,隨著更多人工智慧聊天機器人進入市場,網站所有者也應該密切注意。 Gemini 是該領域的另一個大牌,但人們對其訓練資料集知之甚少。當然,我們知道Google搜尋機器人會不斷抓取網頁,但這並不一定意味著 Gemini 也能存取相同的資料。查看 ChatGPT 與 Google Gemini:哪種型號更適合程式設計?
為什麼有些網站所有者會擔心?
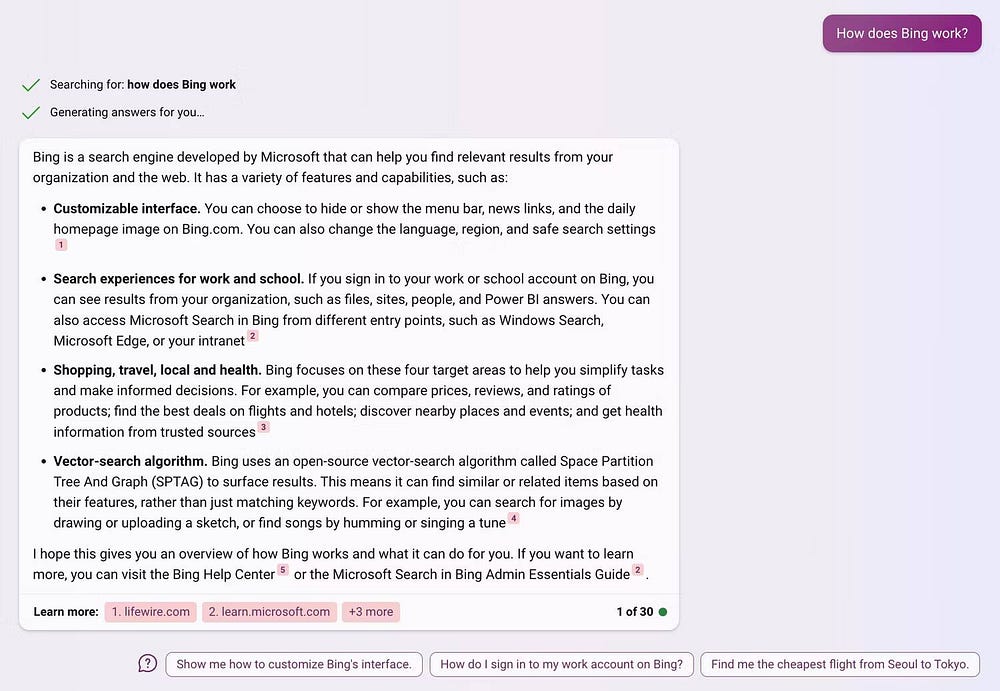
網站所有者最擔心的是,像 ChatGPT、Gemini 和 Bing Chat 這樣的人工智慧模型會降低其內容的價值。聊天機器人利用現有內容產生回复,但這也降低了用戶訪問原始來源的必要性。用戶無需訪問網站即可獲取信息,只需訪問 Google 或 Bing 即可生成所需信息的摘要。
當談到人工智慧聊天機器人在搜尋領域的應用時,網站所有者最擔心的就是流量流失。而 Gemini 的情況則很少包括流量流失。 人工智慧模型 在您的回覆中引用來源,告訴使用者您從哪些頁面獲取資訊。
因此,除了用人工智慧回應取代網站訪問之外,Gemini 幾乎消除了任何來源網站獲得流量的可能性——即使用戶想要了解更多資訊。另一方面,Bing Chat 更常與資訊來源關聯。



換句話說,目前的生成式人工智慧工具正在系統性地利用內容創作者的勞動來取代對內容創作者的需求。最終,你必須要問,這給網站所有者留下了什麼動力去繼續發布更新的內容?而且,如果網站停止發布它們賴以產生可靠回應的內容,人工智慧機器人又會怎麼樣呢?查看 以負責任的方式使用人工智慧作為內容作者或編輯.
如何防止人工智慧聊天機器人造訪你的網站
如果您不想讓 AI 機器人使用您的網站內容,您可以使用 robots.txt 檔案阻止它們存取您的網站。但遺憾的是,您必須逐一阻止每個機器人,並透過名稱進行識別。
例如,一個常見的爬蟲程式稱為 CCBot,您可以透過在 robots.txt 檔案中新增以下程式碼來封鎖它:
使用者代理:CCBot 禁止存取:/
這將阻止共同爬行機器人將來爬行您的網站,但不會刪除以前爬行中收集的任何資料。
如果您擔心新的 ChatGPT 功能會影響網頁內容,我已發布 OpenAI 目前已經有關於如何封鎖其聊天機器人的說明。在本例中,ChatGPT 機器人名為 ChatGPT-User,您可以透過在 robots.txt 檔案中新增以下程式碼來封鎖它:
使用者代理:ChatGPT-User 禁止存取:/
然而,阻止搜尋引擎AI機器人抓取你的內容又是另一個問題。由於Google對其使用的訓練資料非常保密,因此您無法確定需要封鎖哪些機器人,以及它們是否會遵守robots.txt檔案中的命令(許多爬蟲程式並不遵守)。查看 最佳免費和付費網站內容修改監控工具.
這種方法有多有效?
在 robots.txt 檔案中封鎖 AI 模型是目前最有效的方法,但並不是特別可靠。
第一個問題是,你必須指定每個要封鎖的聊天機器人,但誰能追蹤每個上市的AI機器人呢?下一個問題是,robots.txt檔案中的命令是非強制性的。雖然協同爬蟲、ChatGPT和許多其他機器人都遵循這些命令,但許多工具卻不遵循。
另一個要注意的是,你只能阻止 AI 機器人執行未來的爬取操作。你無法刪除先前爬取的數據,也無法向 OpenAI 等公司發送請求,要求其刪除所有數據。 OpenAI ChatGPT 的一些重大問題.
是否應該禁止人工智慧工具造訪該網站?
遺憾的是,目前沒有簡單的方法可以阻止所有AI聊天機器人訪問您的網站,手動阻止每個機器人幾乎是不可能的。即使您跟上網路上最新的AI機器人,也無法保證它們都會遵守robots.txt檔案中的命令。
這裡真正的問題是結果是否值得付出努力,簡短的回答是(絕對)不值得。
阻止AI機器人造訪你的網站也存在一些潛在的弊端。最重要的是,你將無法收集有意義的數據來證明像Gemini這樣的工具是幫助還是損害了你的搜尋行銷策略。
是的,你可以假設引用不足是有害的,但如果你因為阻止人工智慧機器人存取你的內容而缺乏數據,你就無法猜測了。谷歌首次推出時也出現了類似情況 精選摘錄 去搜尋。
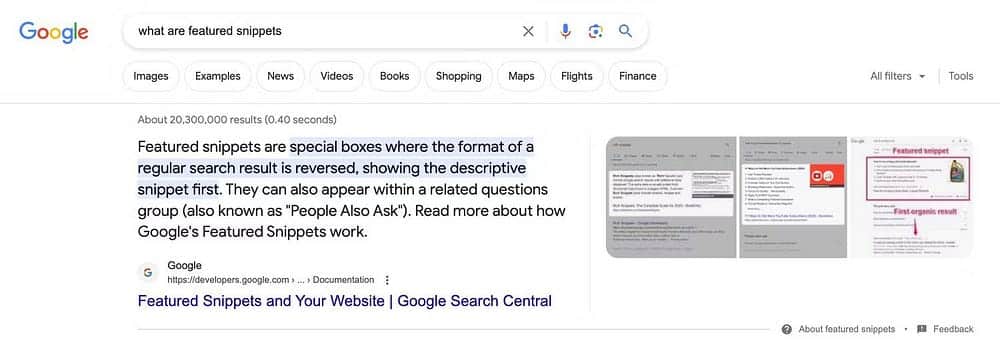
對於相關查詢,Google 會在結果頁面上顯示網頁內容片段,以回答使用者的問題。這意味著用戶無需點擊進入網站即可獲得他們想要的答案。這引起了依賴搜尋查詢流量的網站所有者和 SEO 專家的恐慌。
然而,觸發精選摘要的查詢類型通常是低價值搜索,例如“X 是什麼”或“紐約的天氣怎麼樣”。任何想要深入了解資訊或全面天氣預報的人都會繼續點擊結果,而那些不想要深入了解資訊或全面天氣預報的人從一開始就沒有那麼大的價值。
你可能會發現,生成式人工智慧工具的情況也類似,但你需要數據來證明這一點。查看 使用生成式人工智慧工具時應避免的錯誤.
不要急於做任何事
網站所有者和發布者對人工智慧技術的擔憂,以及對機器人利用其內容生成即時回應的想法感到沮喪,這完全可以理解。然而,現在並非倉促反擊的時機。人工智慧是一個快速發展的領域,未來將持續快速發展。不妨藉此機會了解人工智慧的發展情況,並分析其帶來的潛在威脅和機會。
目前依賴內容創作者勞動來取代他們的體係是不可持續的。無論是像Google和OpenAI這樣的公司改變做法,或是政府推出新的監管規定,都必須有所作為。同時,人工智慧聊天機器人對內容創作的負面影響也日益凸顯,網站所有者和內容創作者可以將其轉化為優勢。現在,您可以查看 政府監管人工智慧工具的方式.