毫無疑問,NVIDIA 憑藉其廣受歡迎且多樣化的顯示卡產品線,繼續在平行運算領域佔據主導地位。但隨著 AMD 的 Instinct AI 加速器為其兩台最新、最大的超級電腦(Frontier 和 El Capitan)提供支持,以及社區對開源 ROCm 平台日益增長的支持,NVIDIA 或許已經找到了迄今為止最大的競爭對手。
那麼,AMD Instinct AI 加速器究竟是什麼呢?它為何如此強大?與 NVIDIA 的 Tensor GPU 相比又如何?快來看看吧! 搭載 AMD 處理器的主機板和配備 Intel 處理器的主機板有什麼不同?
快速連結
什麼是 AMD Instinct?
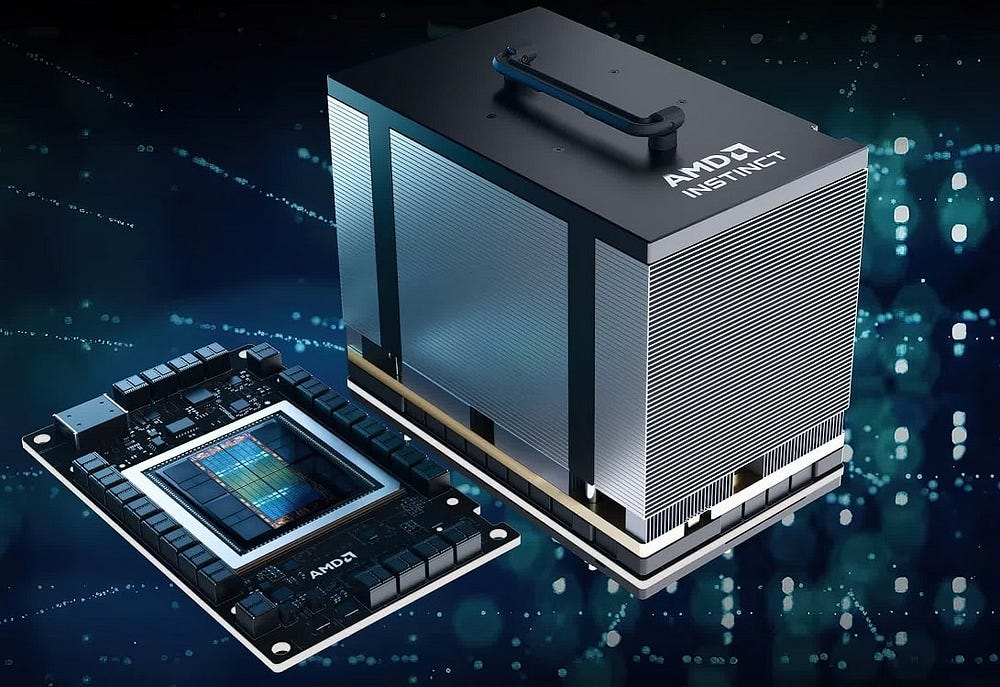
AMD Instinct GPU 是一種用於高效能運算 (HPC) 和 AI 加速處理的企業級裝置。與普通消費級 GPU 不同,Instinct GPU 透過軟體和硬體創新進行了最佳化,可處理 AI 學習、大數據處理和其他高效能任務。
AMD Instinct 系列 GPU 曾協助首台突破百億億次運算極限的超級計算機,其雙精度運算速度達到每秒 1.1 EFLOP。目前,搭載 Instinct GPU 的超級電腦正被用於癌症治療、永續能源和氣候變遷等領域的研究。
高效能運算 (HPC) 已成為現代社會不可或缺的一部分,它執行科學研究、工程、安全和其他領域所需的複雜模擬和運算。然而,隨著對高效能運算 (HPC) 的需求不斷增長(尤其是在超級電腦和大型資料中心),人們對其環境影響的擔憂也日益加深。近年來,考慮到資料中心對整體擁有成本和氣候問題的影響,人們越來越關注其永續性。
Instinct GPU 如何加速智慧與高效能運算
為了使世界上最強大的大型主機和超級電腦實現百億億次處理能力,AMD Instinct 加速器必須配備大量技術改進和創新。
讓我們討論一下 AMD Instinct GPU 中使用的一些新技術和更新技術。
1. CDNA架構技術
最近的 AMD Instinct 加速器(從 MI100 開始)使用了該公司的 CDNA 架構。
CDNA 主要關注平行處理、記憶體層次結構以及透過其專有的 Matrix Core 技術提升計算效能等功能。即使是在單一伺服器上運行的 HPC、AI 或機器學習,CDNA 也能支持,甚至支援大規模百億億次級電腦。
AMD 的 Matrix Core 技術透過支援混合精度運算來加速 AI 學習。憑藉不同精度的運算能力,Instinct GPU 能夠根據所需的精度等級有效地進行矩陣運算。
最常見的精確度運算格式包括 FP64、FP32、FP16、BF16 和 INT8。 FP 代表浮點數,BF 代表腦浮點數,INT 代表整數。格式中對應的數字越大,精度越高。 64 位元運算稱為雙精度。 32 位元運算稱為單精度,16 位元運算稱為半精度,依此類推。
由於大部分深度學習模型的訓練並不需要太高的精確度,因此能夠以一半甚至四分之一的精度進行矩陣運算進行推理可以顯著減少工作量,從而加速人工智慧學習。查看 我的 Snapchat 或 ChatGPT 人工智慧:您應該使用哪一個?
2. 高頻寬記憶體(HBM)
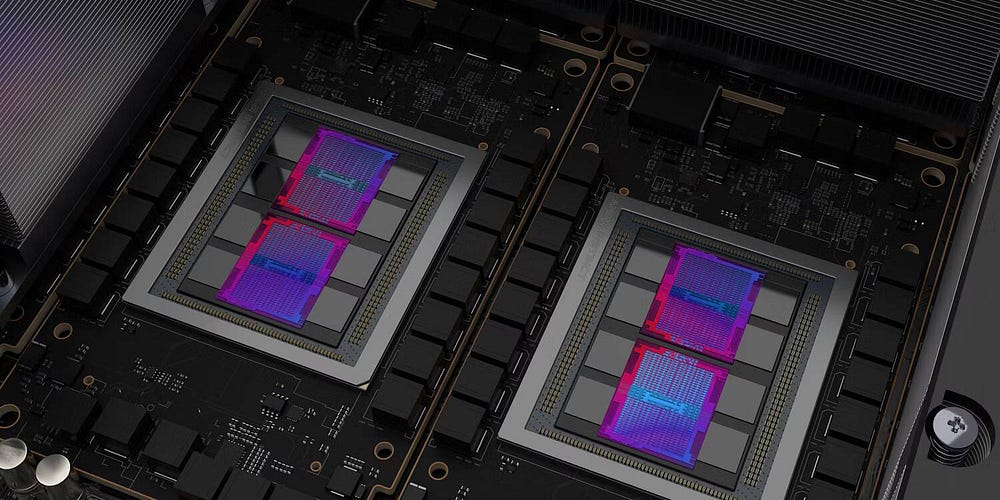
每款 AMD Instinct 加速器均配備多達 880 個矩陣核心。 AMD 的矩陣核心處理器能夠執行每秒 383 TFLOP 的半精度運算,因此高速記憶體至關重要。 AMD 最新的 Instinct 產品配備高頻寬記憶體 (HBM),而非常見的 DDR4 或 DDR5 RAM。
與傳統記憶體不同,HBM 採用所謂的三維堆疊架構。這種架構指的是將 DRAM 模組垂直堆疊的設計方法。這種設計允許模組在垂直和水平方向上同時堆疊,因此被稱為三維堆疊。
利用這種 5D 堆疊技術,HBM 可以實現每個模組高達數百 GB 的實體記憶體容量,而 DRRXNUMX 每個模組只能處理數十 GB 的容量。除了容量之外,HBM 還以比常規 DDR 記憶體更高的吞吐量效能和更佳的能源效率而聞名。
3. 無限布料
Instinct GPU 的另一項創新是 AMD 的 Infinity Fabric 技術。 Infinity Fabric 是一種互連繫統,可動態智慧地連接 CPU 和 GPU,使元件之間能夠有效率地通訊。
使用 Infinity Fabric,元件不再透過常規匯流排進行連接,而是以網狀配置進行連接,頻寬可以達到每秒數百千兆位元。
除了網狀互連之外,Infinity Fabric 還使用嵌入在每個模組中的感測器來動態控制頻率、資料傳輸速率和其他自適應行為,從而提高效能並降低延遲。
4. ROCm開發平台
NVIDIA 的 CUDA(運算統一裝置架構)是訓練 AI 模型最廣泛的開發平台。 CUDA 的問題在於它僅適用於 NVIDIA GPU。這也是 NVIDIA 佔據 HPC 和 AI 加速器絕大部分市場份額的主要原因之一。
為了在高效能運算 (HPC) 和人工智慧 (AI) 市場佔據更大份額,AMD 不得不開發自己的平台 ROCm (Radeon Open Compute)。 ROCm 是一個開源軟體平台,允許將 Instinct GPU 用作 AI 加速器。
ROCm 雖然並非 Instinct 硬體的必要組成部分,但對於 Instinct GPU 產品線的生存至關重要。借助 ROCm,開發者和研究人員可以獲得 ROCm 工具、編譯器、核心驅動程式、全套程式庫,以及存取 TensorFlow 和 PyTorch 等框架,從而使用他們喜愛的 AI 程式語言進行開發。
AMD Instinct AI 加速器與 Radeon 加速器相比如何?
AMD 提供企業級 GPU 的 Instinct 系列,以及主流消費者的 Radeon GPU。如前所述,Instinct 處理器採用 AMD 的 CDNA 架構、HBM 和 Infinity Fabric 互連技術。而 Radeon 處理器則採用 AMD 的 RDNA 架構、DDR6 記憶體和 Infinity Cache。
Radeon 系列 AI 加速器雖然效能略遜一籌,但每個運算單元仍配備一到兩個 AI 加速核心。最新的 Radeon RX7900 XT GPU 每個運算單元配備兩個 AI 加速核心,可實現 103 TFLOP 的峰值半精度運算能力和 52 TFLOP 的峰值單精度運算能力。
雖然 Instinct 系列 GPU 更適合 LLM 和 HPC,但 Radeon AI 加速器可用於微調預訓練模型、推理和圖形密集型任務。
AMD Instinct 與 NVIDIA Tensor 對比
據調查 集邦科技 NVIDIA 佔據伺服器 GPU 市場約 80% 的份額,而 AMD 僅佔剩餘的 20%。 NVIDIA 的巨大成功源於其在 GPU 設計和組裝方面的專業知識。這使其能夠設計出性能卓越的 GPU,令其他產品望塵莫及。
讓我們來比較一下 AMD 的 Instinct MI205X 和 NVIDIA 的 H100SXM5,使用的規格如下: AMD 官方網站NVIDIA 資料表 她自己的:
| GPU 類型 | FP64(TFLOP) | FP32(TFLOP) | FP16(TFLOP) | INT8(TFLOP) |
|---|---|---|---|---|
| AMD 本能 MI250X | 30.0 | 60.0 | 1000 | 2000 |
| NVIDIA H100SXMS | 47.9 | 95.7 | 383.2 | 383 |
從表中可以看出,AMD 的 MI250X 在雙精度和半精度計算方面表現更佳,而 NVIDIA 的 H100SXMS 在半精度和四分之一精度矩陣計算方面表現更佳。這使得 AMD 的 MI250X 更適合高效能運算 (HPC),而 NVIDIA 的 H100SXMS 更適合 AI 學習和推理。查看 Linux 上的 AMD 與 NVIDIA 顯示卡:您應該使用哪一款?
AMD Instinct 處理器的未來
雖然 AMD 的最新產品 MI250X 專為高效能運算 (HPC) 而設計,但即將推出的 MI300 則更專注於 AI 訓練。這款 AI 加速器被宣傳為 APU,將 GPU 和 CPU 整合在一個封裝中。這使得 MI300 GPU 能夠利用 CNDA3 統一記憶體 APU 架構,其中 GPU 和 CPU 僅使用一個內存,從而提高效率並降低價格。
雖然 AMD 目前在 AI 加速器市場上還無法與 NVIDIA 競爭,但一旦 MI300 上市,ROCm 得到改進,AMD 的 Instinct 系列就足以從 NVIDIA 手中奪走相當一部分 AI 加速器市場。現在就可以看看。 Nvidia GTX 和 Nvidia RTX 有什麼不同?