我們如今使用的大多數人工智慧工具都運行在雲端運算上,這意味著它們需要持續的網路連線。雖然有一些選擇可以在設備上本地運行人工智慧工具,但普遍認為這樣做需要強大且昂貴的硬體。
我以前也是這麼想的,直到我決定在一台相對較舊的機器上測試一些原生AI工具——一塊已經使用了近十年的GTX 1070顯卡——才發現這實際上是可行的,而且效果顯著。這項實驗為即使在配置一般的設備上也能使用AI開闢了新的可能性,讓這項技術能夠被更廣泛的用戶所接受。

快速連結
為什麼需要使用本地 AI 聊天機器人?
我使用過無數的人工智慧線上聊天機器人,例如 ChatGPT、Gemini、Claude 等等。它們都很棒。但是,當你沒有網路連接,仍然想使用人工智慧聊天機器人時,該怎麼辦呢?或者,如果你想處理一些非常私密的事情,或者需要處理一些因工作或其他原因不能透露的資訊時,該怎麼辦呢?
這時你就需要一個本地的、離線的大型語言模型 (LLM),將所有對話和資料保存在你的裝置上。使用 本地人工智慧聊天機器人 無需依賴網路連線即可利用人工智慧的力量。
隱私受到重視 使用大型本地語言模型的主要原因之一是但也有其他原因,例如避免審查、離線使用、節省成本、客製化等。它為您提供 本地人工智慧聊天機器人 完全控制您的數據,確保您的敏感資訊安全無虞。
什麼是量化大型語言模型(Quantized LLM)?
對於大多數想要在本地使用大型語言模型 (LLM) 的人來說,硬體是最大的挑戰。最強大的 AI 模型需要強大的硬體來運作。除了易用性之外,硬體限制也是大多數 AI 聊天機器人基於雲端運算的另一個原因。
硬體限制是我之前認為無法原生運行大型語言模型 (LLM) 的原因之一。我現在有一台相當普通的電腦,配備了 AMD Ryzen 5800x 處理器(2020 年推出)、32GB DDR4 記憶體和 GTX 1070 顯示卡(2016 年推出)。所以,這台電腦的硬體配置不算頂級,但考慮到我現在很少玩遊戲(即使玩,我也會選擇 較老、資源密集程度較低的獨立遊戲) 以及現代 GPU 的高成本,我對我所擁有的感到滿意。
然而事實證明你並不需要最強大的 AI 模型。 量化大型語言模型(量化 LLM) 它們是透過簡化所使用的數據(特別是帶有小數點的數字)而變得更小、更快的人工智慧模型。
AI 通常使用高精度數字(例如 32 位元小數)進行運算,這會消耗大量記憶體和處理能力。量化會將這些數字降低為低精確度數字(例如 8 位元整數),而不會顯著改變模型的行為。這意味著模型運行速度更快,佔用的儲存空間更少,並且可以在較小的設備(例如智慧型手機或外圍硬體)上運行,儘管有時會略微降低精度。
這意味著,雖然我的舊硬體肯定很難運行像 3.1 億參數 Llama 205 一樣強大的大型語言模型 (LLM),但它可以運行較小的 8B 量子模型。
什麼時候 OpenAI宣布 對於我的第一個完全量化的開放加權推理模型,我想是時候看看它們在我的舊硬體上運行得如何了。
如何使用 Nvidia GTX 1070 顯示卡和 LM Studio 在本機使用大型語言模型 (LLM)?
首先,我想聲明一下,我並非本地大型語言模型 (LLM) 的專家,也不精通我用來在我的機器上運行這個智慧模型的軟體。我在這裡只是簡單介紹一下如何在我的 GTX 1070 顯示卡上本地運行智慧聊天機器人,並評估該解決方案的效率。我的目標是演示如何利用現有的運算能力來運行高級 AI 模型,而無需依賴雲端服務。
下載 LM Studio
要在本地運行大型語言模型 (LLM),你需要專門的軟體。具體來說,一個程序 LM工作室,這是一款免費工具,可讓您在裝置上本地下載並執行 LLM 模型。前往 LM Studio 主頁並選擇 下載 [作業系統] (我使用 Windows 10。)LM Studio 是開發人員和研究人員的理想平台,他們希望在部署之前嘗試不同的大型語言模型並在個人機器上評估其效能。
這是標準的 Windows 安裝流程。執行安裝程序,完成安裝,然後啟動 LM Studio。我建議選擇 高級用戶 因為它會顯示一些您可能想要探索的實用選項。此選項可以更好地控製程式的設定和進階選項,從而自訂使用 LLM 模型的體驗。使用 LM Studio,您可以輕鬆且有效率地探索大型語言模型的世界。
下載您的第一個本機 AI 模型
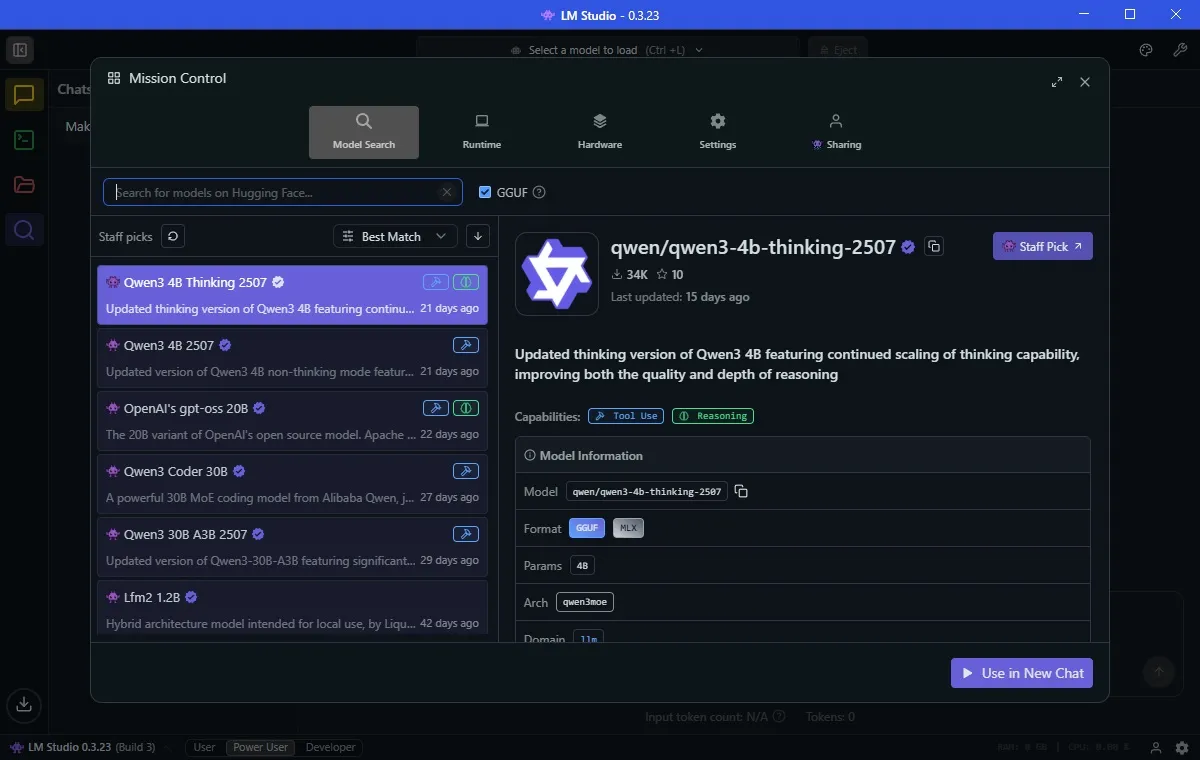
安裝完成後,您可以載入您的第一個大型語言模型 (LLM)。選擇選項卡 瀏覽 (放大鏡圖示)。 LM Studio 可輕鬆顯示最適合您裝置運行的原生 AI 模型。
就我而言,它建議下載一個名為 Qwen 3-4b-思考-2507模特兒名稱是Qwen(由中國科技巨頭阿里巴巴開發),這是該模型的第三個版本。值「4b」表示模型擁有 2507 億個參數可用於回覆您,而「思考」則表示模型會花時間思考其答案,然後再回應。最後,25 是該模型的最後一次更新,即 XNUMX 月 XNUMX 日。
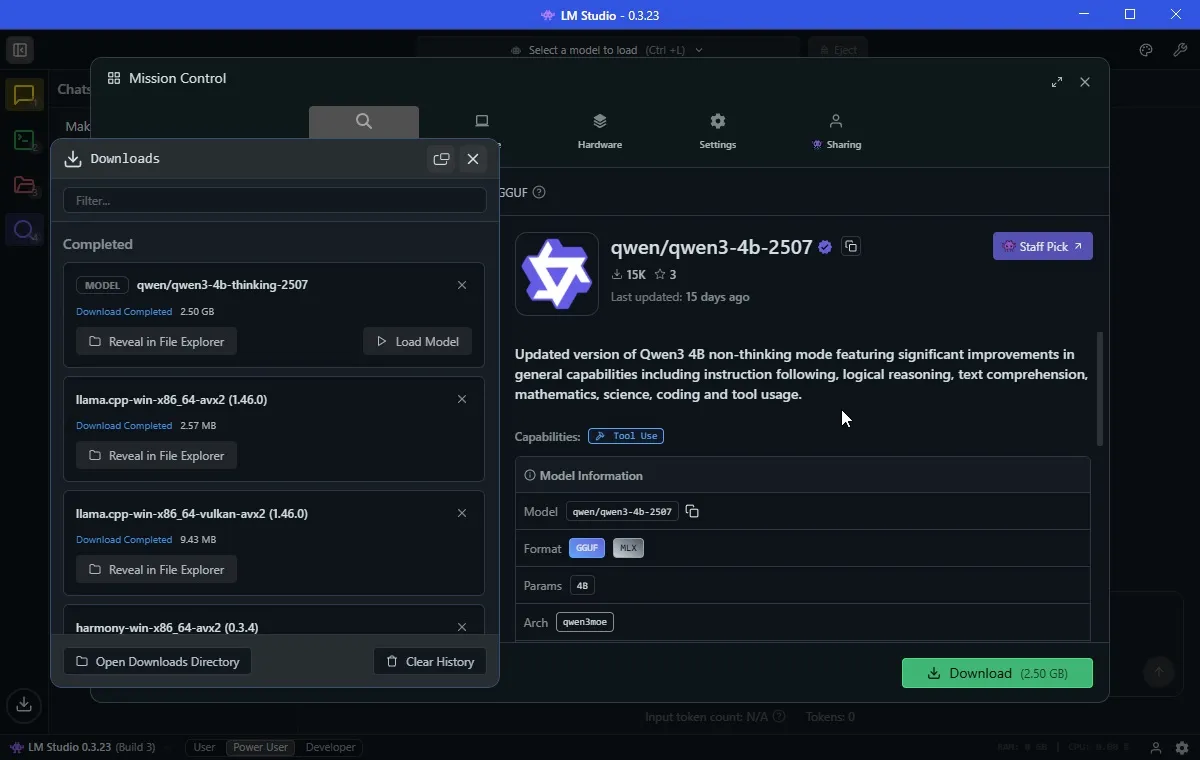
Qwen3-4b-thinking 的大小只有 2.5 GB,所以下載應該很快。我之前也下載過 OpenAI/gpt-oss-20b,大小更大,為 12.11 GB。它還包含 20 億個參數,所以應該能提供「更好」的答案,儘管這會佔用更多資源。
現在,除了 人工智慧模型命名的複雜性下載 LLM 後,您幾乎就可以開始使用它了。
在運行AI模型之前,請前往選項卡 硬體 確保 LM Studio 正確識別您的系統。您也可以向下捲動並調整 護欄 好了。我已經將電腦上的防火牆設定為 均衡,防止任何一個AI模型消耗過多的資源,從而導致系統過載。
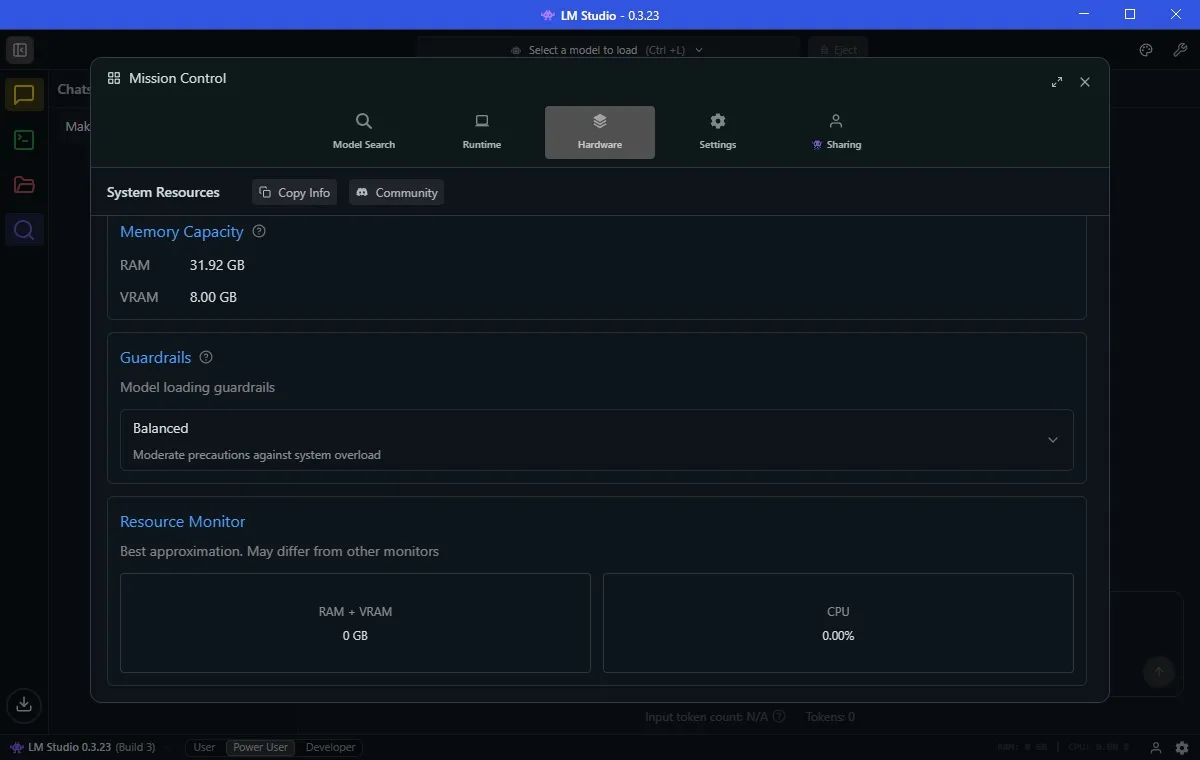
您還會注意到 資源監視器 護欄下方。這是一種查看 AI 模型系統使用情況的簡單方法。如果您像我一樣使用相當有限的硬件,則值得監控,因為您不希望系統意外崩潰。
上傳您的 AI 模型並開始使用它。
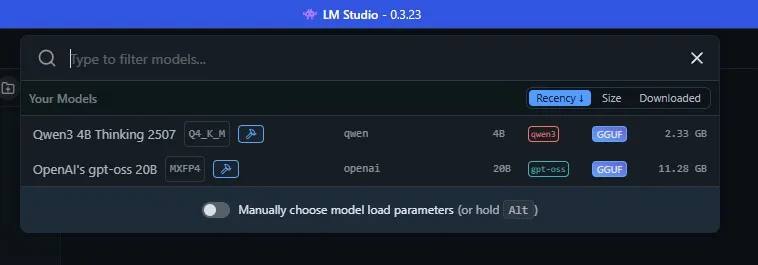
現在,您已準備好在裝置上本機使用您的 AI 聊天機器人。在 LM Studio 中,選擇頂部欄(用作搜尋工具)。選擇 AI 名稱會將 AI 模型載入到您的電腦記憶體中,然後您就可以開始輸入命令和問題。此過程對於直接在您的裝置上啟用大型語言模型 (LLM) 的功能至關重要,讓您能夠以互動方式快速體驗 AI,而無需持續的網路連線。請記住,模型效能取決於您設備的規格,因此請確保您擁有足夠的資源來有效地運行您的 AI 模型。
在舊硬體上本地運行 AI 模型:很棒,但有局限性
在本地運行 AI 模型可以讓您以常規方式從中受益,但您應該注意一些重要的限制。這些本地模型雖然有用,但不如 ChatGPT 中使用的 GPT-5 等最先進的模型那麼強大。此外,您會注意到思考和回應過程需要更長的時間,並且響應品質可能會有很大差異。
為了說明這一點,我在 Qwen 和 gpt-oss 上測試了一個經典的大型語言模型 (LLM),儘管等待了很長時間,但都成功完成了任務。這表明,在舊機器上使用原生 AI 模型可能是一個切實可行的解決方案,但這需要耐心,並且需要了解舊硬體的局限性。
艾倫、鮑伯、柯林、戴夫和艾蜜莉站成一圈。艾倫在鮑勃的左邊。鮑伯在科林的左邊。科林在戴夫的左邊。戴夫在艾米莉的左邊。艾倫的右邊是誰?
Qwen 花了 5 分 11 秒才得出正確結論。 GPT-5 只花了約 45 秒。但誰的表現超越了所有人呢? GPT-oss-20b 的記錄時間為 31 秒。
一次測驗不夠,所以我又嘗試了另一個旨在測試AI推理能力的謎題。在先前的測試中,OpenAI的最新模型GPT-5未能通過這項測試,所以我很想看看Qwen和gpt-oss的離線版本會如何處理這個問題。
人工智慧模型解決邏輯問題的效能分析
解決邏輯問題的能力對人工智慧模型來說是一項真正的挑戰。上面的例子涉及識別一群人之間的空間關係,說明了這些模型的表現差異有多大。
空間關係與人工智慧的挑戰
處理空間關係是人工智慧的基礎,需要敏銳的語言理解能力和邏輯推理能力。前面的範例表明,某些模型(例如 GPT-OSS-20B)擅長處理空間關係,而其他模型(例如 Qwen 和 GPT-5)則需要更長時間才能得出正確的解決方案。
各種測試對於評估人工智慧的重要性
任何單一的測試都無法全面評估人工智慧的能力。有必要進行涵蓋智能不同方面的各種測試,例如邏輯推理、語言理解和複雜問題解決。這樣才能更準確地評估每個模型的能力和限制。
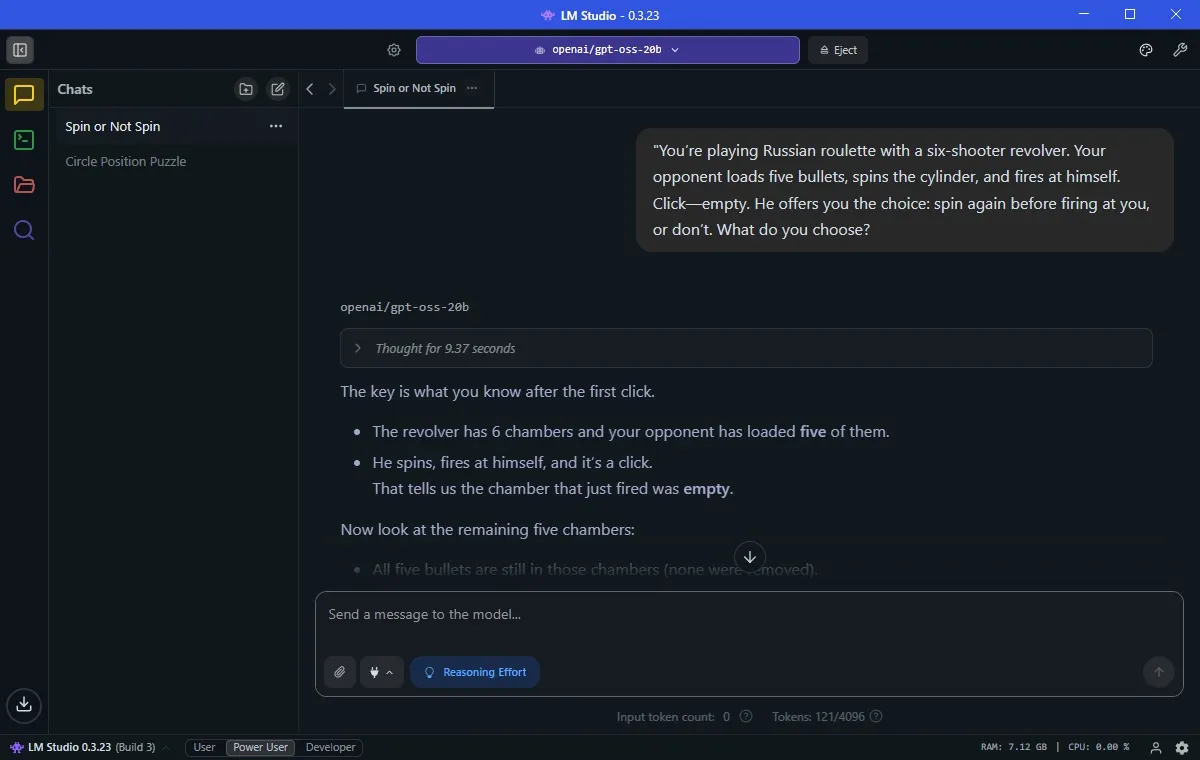
想像一下,你用一把六發手槍玩俄羅斯輪盤賭。你的對手裝上五顆子彈,旋轉彈鼓,然後開槍自殺。 「Tick」的意思是子彈空了。然後他讓你選擇:在他開槍之前,你願意再旋轉一次彈鼓嗎?還是不?你會選擇什麼?
Qwen 模型能夠在 41 分 5 秒內給出正確答案,考慮到硬體限制,這已經相當不錯了。然而,令人驚訝的是,GPT-20 未能解決這個問題,這確實令人驚訝。它甚至還提供了一個圖表來說明為什麼它正確。 gpt-oss-9b 再次在 XNUMX 秒內給了正確答案。
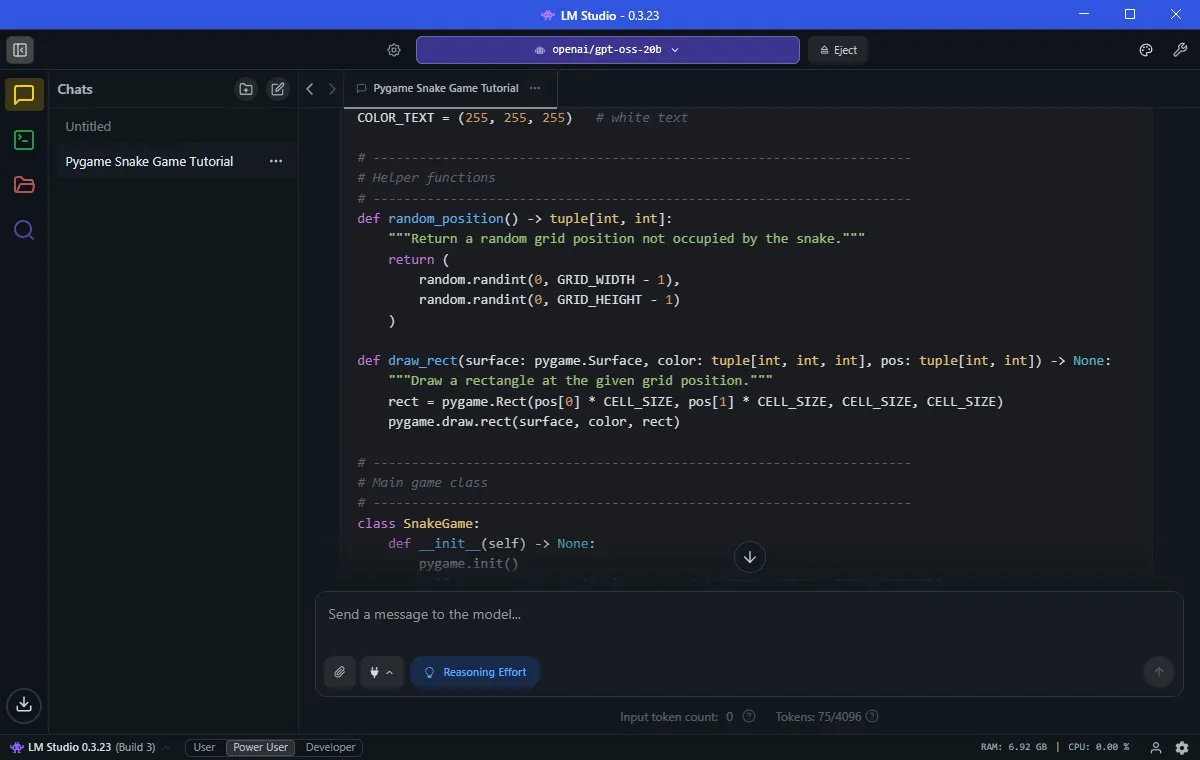
在其他領域,我也看到了立竿見影的效果。我讓 gpt-oss “用 pygame 寫一個貪吃蛇遊戲”,一兩分鐘內,我就寫出了一個功能齊全的貪吃蛇遊戲。這證明了該模型能夠有效地生成遊戲。
在舊裝置上執行 AI 模型
在舊硬體上原生運行大型語言模型 (LLM) 的關鍵在於選擇適合您硬體能力的 AI 模型。雖然 Qwen 版本表現良好,是 LM Studio 中的最佳選擇,但 OpenAI 的 gpt-oss-20b 模型顯然是更優的選擇。
但平衡你的期望很重要。雖然 gpt-oss 準確地回答了問題(並且比 GPT-5 更快),但我無法向它輸入大量數據進行處理。我的硬體限制很快就會顯現出來。
在嘗試之前,我確信在舊硬體上運行原生 AI 聊天機器人是不可能的。但多虧了量子模型和 LM Studio 等工具,這不僅成為可能,而且出奇地實用。
然而,你無法獲得像 GPT-5 這樣的雲端運算引擎那樣的速度、準確度和推理深度。本地運行需要權衡:你獲得了隱私、離線存取和對資料的控制權,但同時也犧牲了一些效能。
然而,七年前的 GPU 和四年前的 CPU 竟然能夠處理現代人工智慧,這本身就令人興奮不已。如果您因為沒有高階硬體而猶豫不決,別擔心—局部量子模型或許是您邁向離線人工智慧的途徑。使用合適的人工智慧模型,可以最大限度地利用您的舊硬體。