隨著先進人工智慧技術的出現,語言模型也出現了多個版本,例如 ChatGPT、Gemeni 和 Claude,每個版本都有其獨特的優點。了解這些模型之間的差異,可以幫助您根據個人或專業用途的不同需求選擇最合適的模型。
此外,GPT-4o 將於 2024 年 5 月與 GPT-4 一同發布,您可能想知道 ChatGPT 中包含的 AI 模型之間有何區別,以及您真正應該使用哪一個。雖然 OpenAI 的 GPT-4 模型基於相同的基礎,但它們之間存在一些顯著差異,這意味著它們在某些任務上比其他任務更適合,更不用說存取它們的成本了。查看 探索免費存取 GPT-4 的方法。.

那麼,OpenAI 的 GPT-4 模型有什麼差別呢?
GPT-4、GPT-4o 和 GPT-4o mini 有什麼不同?
OpenAI 的 GPT-4 模型包含多個變體,每個變體旨在滿足不同的需求。以下概述了 GPT-4、GPT-4o (Omni) 和 GPT-4o mini 之間的差異。
GPT-4
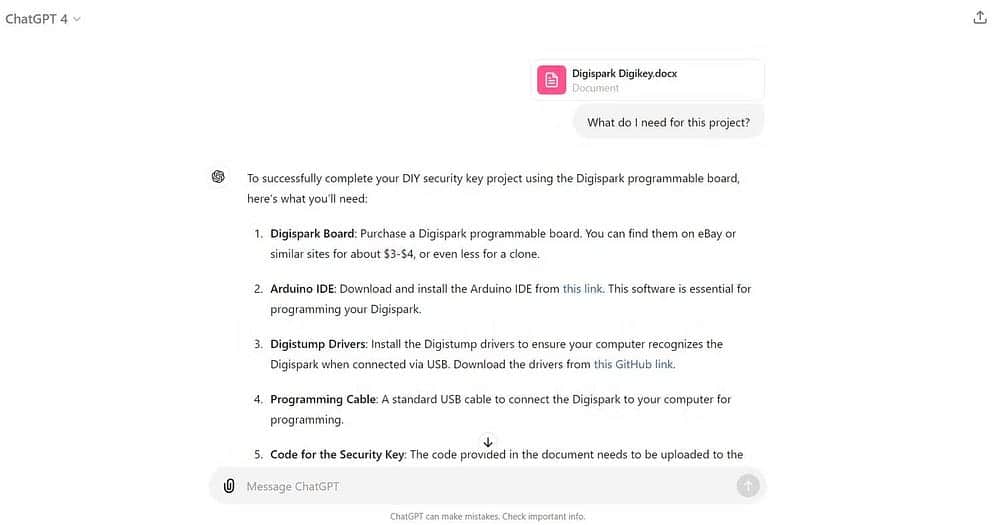
GPT-4 是基礎模型。它能夠理解並產生複雜的句子,用途廣泛,例如創意寫作、數據分析、語言翻譯和程式碼生成。 GPT-4 的上下文視窗容量為 23000 到 25000 字,您還可以附加多個長文檔,並讓它回答有關您上傳文件的任何問題。由於這是該系列的基礎模型,您還可以在 GPT-4 Turbo 和 GPT-4o 中使用 GPT-4 的所有實用功能。
GPT-4o迷你
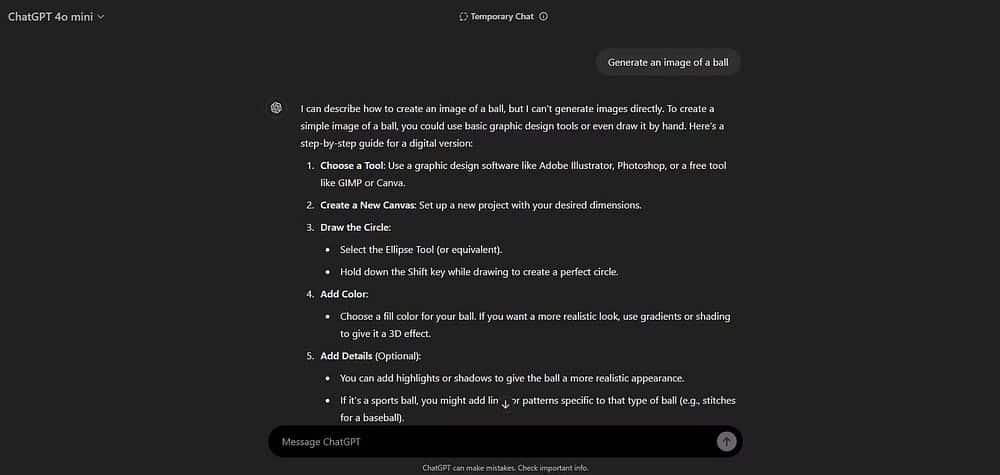
GPT-4o mini 是一個小型語言模型 (SLM),可以與許多大型語言模型 (LLM) 相媲美。儘管 GPT-4o mini 在規模較小、更具體的資料集上進行訓練,但它在響應速度和免費用戶訪問等幾個關鍵方面均優於 GPT-4。
然而,儘管 GPT-4o mini 被設計為多模態模型,但目前版本的 ChatGPT 僅支援文本,無法使用圖像或音訊。此外,與 GPT-4 和 GPT-4o 不同,ChatGPT 不允許 GPT-4o mini 附加文件。 ChatGPT 未來是否會在 GPT-4o mini 中支援多模態功能尚不清楚。查看 您仍然可以嘗試神秘的 GPT-2 聊天機器人,方法如下。.
GPT-4o
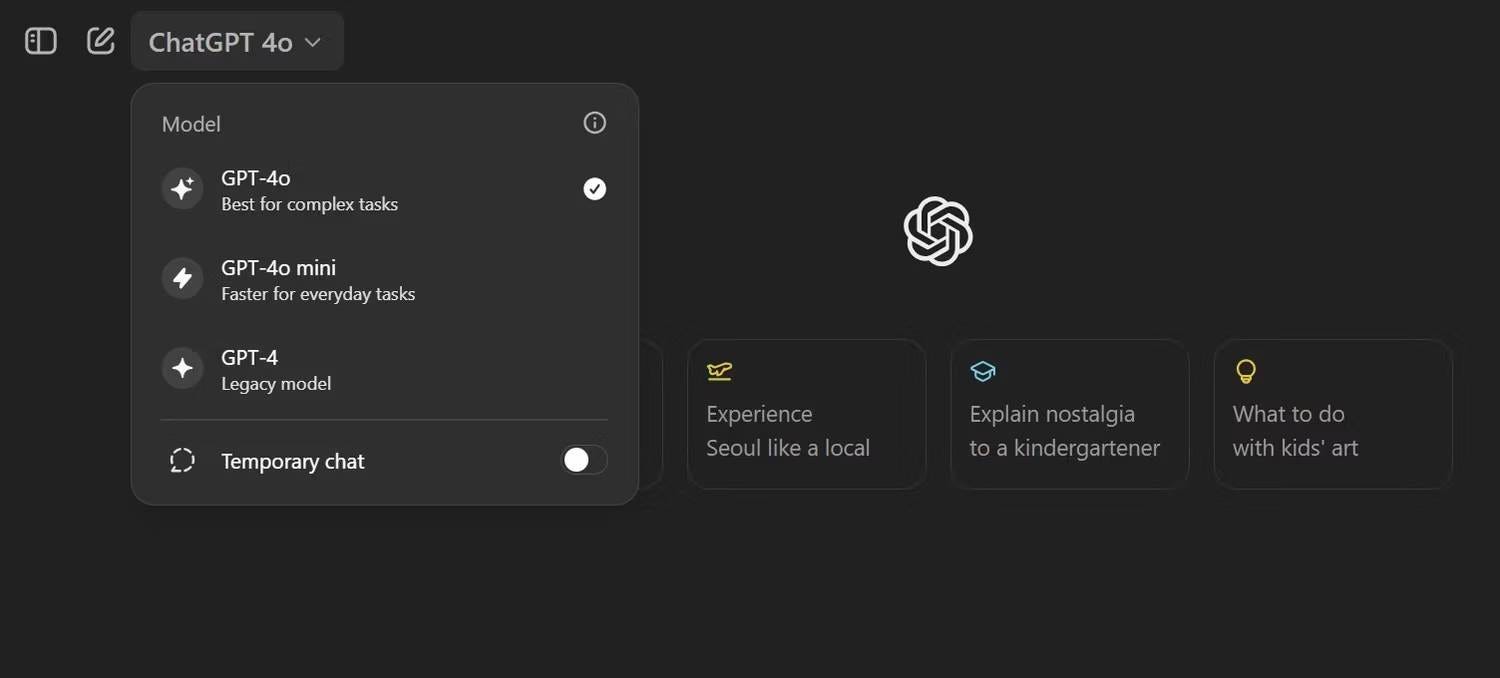
GPT-4o(「o」代表「omni」)是 GPT-4 模型系列的最新成員,也是 ChatGPT 免費和付費用戶的預設模型。模型比 GPT-4 智慧四倍,速度更快,非常適合即時應用。 GPT-4o 是該系列中首個多模態模型,能夠分析文字、音訊、圖像和視訊等所有類型的檔案格式,並可在 ChatGPT 中產生文字和圖像。



此外,OpenAI 允許免費用戶有限地存取 GPT-4o,每三小時發送 16 則訊息。之後,ChatGPT 將恢復使用 GPT-3.5。
以下是每個 GPT-4 模型的細分:
| 特徵 | GPT-4 | GPT-4o | GPT-4o迷你 |
|---|---|---|---|
| 費用(ChatGPT) | 第20話 | 免費(每 3 小時 16 則訊息),20 美元(每 3 小時 80 則訊息) | 免費(每 3 小時 16 則訊息),20 美元(每 3 小時 80 則訊息) |
| 反應能力 | 穆斯林 | 反應速度比 GPT-4 快 4 倍 | 反應速度比 GPT-4o 快 2 倍 |
| 上下文視窗 | 最多 32 個代幣 | 最多 32 個代幣 | 最多 32 個符號 |
| 多媒體輸入/輸出 | لا | نعم | نعم |
| MMLU(模型理解語言的能力) | 86.3 | 88.7 | 82.0 |
| GPTQA(模型回答開放式問題的能力) | 48.0 | 53.6 | 40.2 |
| 數學(數學問題解決模型技能) | 42.5 | 76.6 | 70.2 |
| HumanEval(模型程式設計能力評估) | 67.0 | 90.2 | 87.2 |
除了成本、回應時間和上下文視窗之外,我還為每個模型添加了準確度基準,以幫助比較不同任務的準確度。基準測試包括用於測試學術知識的 MMLU、用於評估常識的 GPQA、用於評估模型程式設計能力的 HumanEval 以及用於解決數學問題的 MATH。在每個測驗中,分數越高越好。
這些標準有助於確定模型在與理解、問答、數學和程式設計相關的各種語言任務上的表現。
- MMLU(大規模多任務語言理解):
MMLU 是一個基準測試,用來衡量模型在各種任務中理解語言的能力。它涵蓋數學、科學、歷史等各領域的測試,評估模型處理多學科資訊的能力。 - GPTQA(GPT問答):
GPTQA 指的是模型回答需要分析和推理的開放式問題的能力。模型的評估是基於其對所提出的問題提供正確且全面答案的準確性和速度。 - 數學:
MATH 是衡量模型解決數學問題能力的標準。模型會接受不同層次的數學問題的測試,例如算術、代數和幾何,以評估其準確性和對數學概念的理解。 - 人類評估:
HumanEval 是用來評估模型程式設計能力的標準。該測試包括向模型提供程式設計問題,並要求其使用特定語言編寫正確的程式解決方案。模型的評估基於其生成的程式碼的品質和準確性,以及其以類似於人類程式設計師的方式理解和解決問題的能力。
您應該使用哪種 GPT-4 模型?
選擇正確的模型取決於您的特定需求和您打算執行的任務的性質。
GPT-4o 是該套件中最強大的模型。它在所有基準測試中都擁有最高的準確率,並且很可能在任何互動中都表現最佳。但是,您可以向 GPT-4o 發送的訊息數量有限,尤其是對於免費套餐用戶而言。這項限制是您應該升級到 ChatGPT Plus 的主要原因。
然而,最好將 GPT-4o 保留用於需要多模態輸入和輸出的交互,或需要最高準確度的情況。由於 GPT-4o mini 在數學、學術知識、程式設計和常識方面的表現優於 GPT-4,因此該模型應該用於需要更高精度的基於文字的查詢。如果您需要附加文件(例如文件、PDF 和音訊),請使用 GPT-4。現在您可以查看 ChatGPT Plus 與 Perplexity:哪個是更好的 AI 聊天機器人?